
 記憶體互連
 PCIe®互連
 CXL®互連


 聯絡我們

 2026-10-19
AI 推論的十字路口:當「參數規模」撞上「記憶體物理極限」
當前大型語言模型(LLM)正經歷從十億(Billions)到萬億(Trillions)參數規模的急劇演進。隨著上下文長度(Context Length)邁向百萬級,傳統以增加 GPU 數量與 HBM(高頻寬記憶體)為核心的擴展模式已達到物理與經濟極限。一個關鍵的技術現實是:在 1M 上下文環境下,單個請求所需的 KV Cache 高達 150GB,這使得局部 HBM 不僅是「昂貴」,在面對高併發的生產環境時,其擴展性在物理層面上已變得難以維繫。根據 2020 年 GPT-3 (175B) 到預測 2026 年的演進趨勢,我們正處於一個關鍵節點:
參數與記憶體線性同步: 從 Llama 3 (8B/14GB) 到 Future LLM (1T/2000GB),記憶體需求隨參數規模線性飆升。如Fig1 [1]
長上下文的 KV Cache 爆炸: 從 8K 長度的 1.3GB 到 1M 長度的 150GB,HBM 供需缺口正持續擴大。如Fig2 [2]
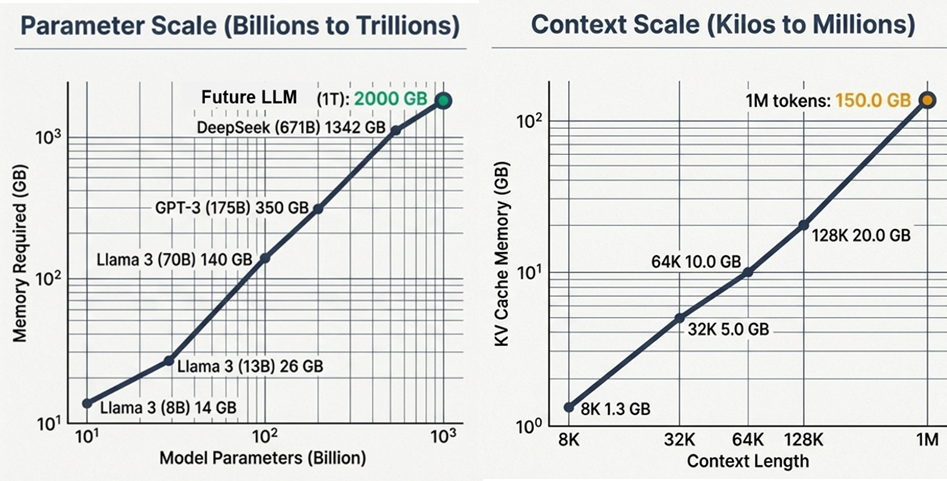
Fig1. Parameter Scale[1] Fig2. Context Scale[2]
演算法演進:從混合專家模型 (MoE) 到 DeepSeek Engram
為了解決稠密模型(Dense)運算帶來的巨大負荷,LLM 架構正由「全啟動」轉向「稀疏啟動(Sparse Activation)」。這一趨勢為硬體分層存儲創造了卸載(Offloading)的機會。
技術深度解析:記憶體狀態的解耦邏輯
Standard Transformer:採用稠密運算,所有參數在每個 Token 生成時皆處於啟動狀態,記憶體完全鎖定在昂貴的 GPU HBM 中。
MoE (Mixture of Experts):透過路由選擇僅啟動 top-k 專家,雖然計算量降低,但仍對 GPU HBM 的利用率有極高要求。
DeepSeek Engram:引入了條件記憶(Conditional Memory),為稀疏化開闢了全新維度。Engram 核心邏輯:計算與查詢的數學解耦。Engram 將模型中的靜態知識(Static Knowledge)提取為 O(1) 的 N-gram 查閱資料表。這在架構上實現了數學解耦:動態推理(Dynamic Reasoning)[4]。
O(1) 查表與 Host RAM 卸載:Deepseek與北京大學聯合發表的論文“Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models” 中明確指出,透過將龐大的 N-gram 查閱資料表(最高達 100B 參數等級)完全卸載至 CPU Host RAM,並利用 Deterministic Addressing(確定性定址)進行預先讀取(Prefetching),可以在不佔用寶貴 GPU HBM 的情況下,實現極低延遲的 O(1) 知識檢索。論文實測顯示,這種將記憶體卸載至 Host DRAM 的做法,對整體輸送量的效能折損不到 3%。[4]
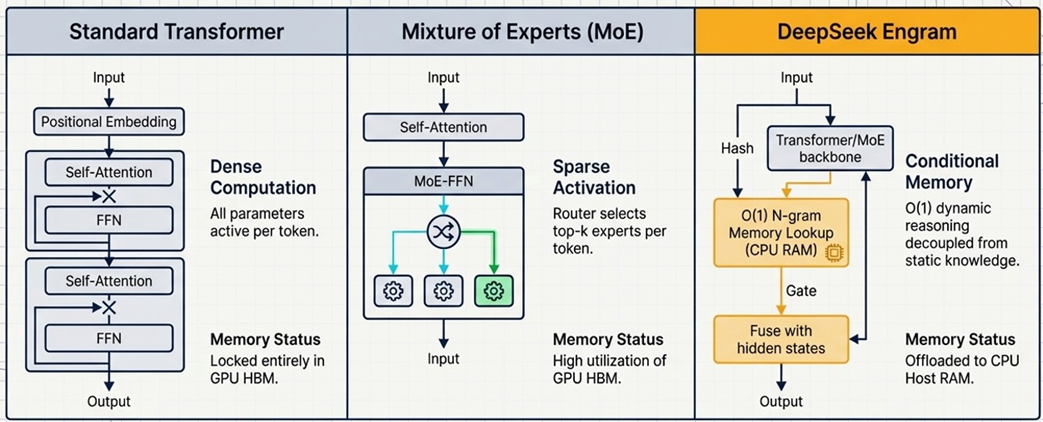
Fig3. 演算法演進:從混合專家模型 (MoE) 到 DeepSeek Engram [4]
MRDIMM:主機記憶體頻寬的二次飛躍
當 Engram 將知識查詢表卸載至主機側,傳統 RDIMM 在面對頻繁且高併發的動態查詢時,其頻寬與延遲表現往往力不從心。 MRDIMM(多重存取雙列直插式記憶體模組)是應對這一高性能查詢需求的核心組件。
硬體架構拆解:偽通道與多路復用
MRDIMM 透過多工架構改進的記憶體控制器實現了頻寬的二次飛躍:
多工拓撲: 藉由多工暫存時脈驅動晶片(MRCD)與多工資料緩衝晶片(MDB),系統能同時訪問兩個物理陣列(Rank)。
80-bit 子通道技術: MDB 將來自 DRAM 側的兩個 80-bit 偽通道(PS0 與 PS1)信號多工復用為單個雙倍資料速率信號,實現 2x Data Rate 的資料傳輸。
並行指令流:MRCD 同時向 PS0 與 PS1 發送指令,確保了極致的訪問並行度。
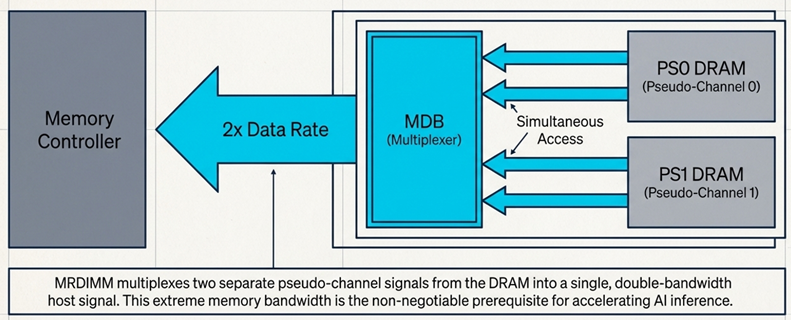
Fig4. MRDIMM 架構 [3]
性能量化分析
MRDIMM 能夠突破傳統 DDR5 速率瓶頸的核心,在於其創新的多工緩衝架構。
晶片組配置:根據 JEDEC 規範,一根標準的 MRDIMM 需要搭載 1 顆 MRCD(Multiplexed Rank Registering Clock Driver)和 10 顆 MDB(Multiplexed Rank Data Buffer)。
資料多工 (Multiplexing):MDB 晶片允許兩個不同的 Rank 在同一個時脈週期內進行並行存取。透過在MDB晶片內部電路,將多個 DRAM 顆粒的低速資料流進行多工處理,MRDIMM 能夠向主機(Host)端輸出兩倍於後端原生 DRAM 的傳輸速率。
性能量化分析在 AI 推論場景的實測對比(MRDIMM 8800 vs. DDR5)顯示:[5]
輸送量優勢: 在併發數為 8 的高負載下,MRDIMM 8800 達到了 39.20 tps,較 DDR5 6400 的 33.00 tps 提升約 18.8%(若相較於基礎的 DDR5 4800,提升幅度更高達 40.5%)。
延遲控制: MRDIMM 在高併發下能將 Token 間延遲穩定維持在 250ms SLA 以下(實測為 206ms)。相比之下,DDR5 6400 的延遲已逼近臨界值(243ms),而 DDR5 4800 則已超標(268ms),顯示 MRDIMM 能更穩妥地確保推論服務的流暢度。
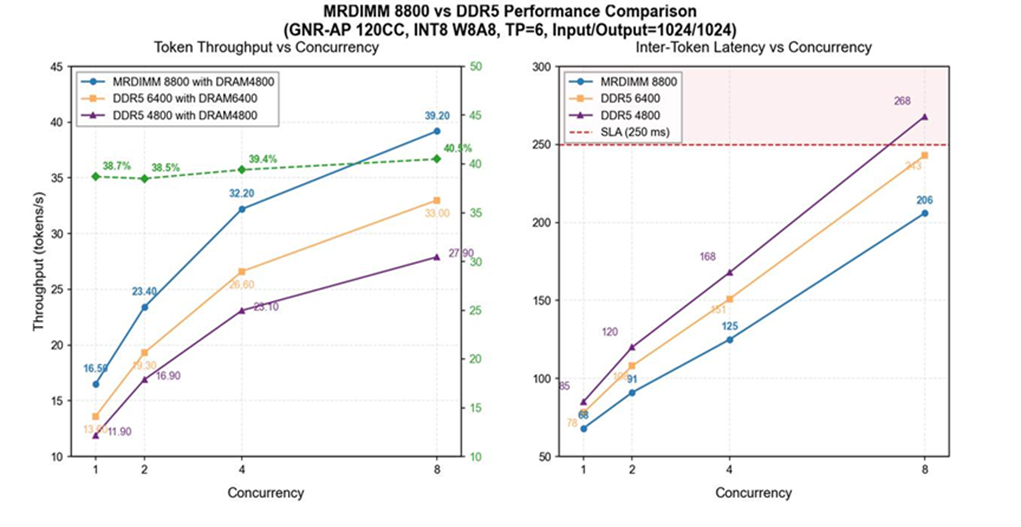
Fig5. Token Throughput and Latency Efficiency [5]
CXL® MXC:構建無限擴展的記憶體資源池
頻寬解決了「速度」問題,但面對萬億級參數帶來的巨型 Engram 查閱資料表,單機節點的插槽限制了「容量」上限。 CXL(Compute Express Link®) 協議下的 MXC(記憶體擴展控制器) 正是打破這一侷限的「記憶體擴展」。
技術規格演進與基礎
CXL 協議正依循 PCIe® 的發展路徑實現跨越式進步:
CXL 1.0/1.1:基於 PCIe 5.0,提供 32GT/s 的一致性記憶體訪問。
CXL 3.0: 基於 PCIe 6.0,提供 64 GT/s 的傳輸速率。核心突破包括支援 記憶體共用 (Memory Sharing)、多級交換架構 (Fabric),以及新增的多頭設備 (Multi-Head) 功能,實現了無交換機直連與大規模資源解耦
CXL 4.0:預計基於 PCIe 7.0 ,頻寬將飆升至 128GT/s 。
CXL NUMA:MXC 支持將 CPU 記憶體資源擴充,將每個 CPU core 所分配到的記憶體資源最大化。
消除 AI 幻覺的數學 prereq
擴大記憶體容量不僅是工程需求,更是數學上的必然要求。實測數據顯示:
雜湊衝突率:隨著記憶體容量擴張,Engram 查閱資料表的雜湊衝突率可從 3.01% 急劇降低至 0.13% 。
準確性提升:降低衝突率是減少模型錯誤匹配、消除「AI 幻覺」的數學先決條件。
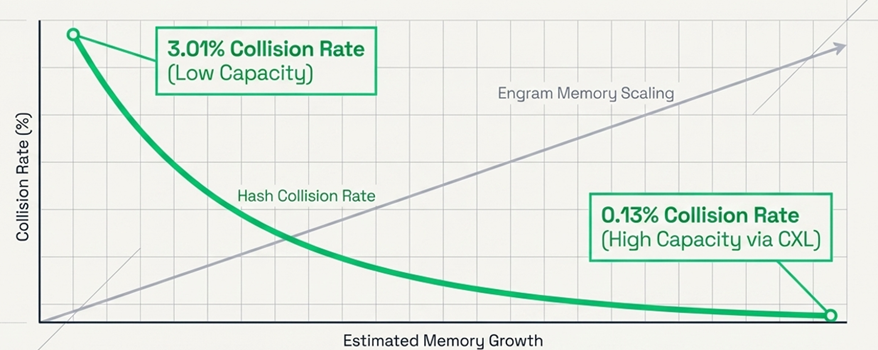
Fig6.Hash Collision vs. Memory Growth [6]
Engram 模組與雜湊衝突 (Hash Collision)
DeepSeek 在論文中提出了「Engram」條件記憶體模組,其運作原理是利用 O(1) 的多頭雜湊尋址(Multi-Head Hashing)來查找模型所需的靜態知識。只要使用雜湊表,系統就必然會面臨「雜湊衝突」的數學物理限制。要降低衝突率、確保知識檢索的準確性(進而消除 AI 幻覺),最直接的數學先決條件就是大幅擴大雜湊表的記憶體容量 (Memory Scaling)。這正是圖表中 X 軸(預估記憶體增長)與 Y 軸(衝突率下降)所呈現的完美反比關係。[6]
突破 GPU 限制與 CXL 擴展 (High Capacity via CXL)
為了解決 GPU 高頻寬記憶體 (HBM) 容量嚴格受限的問題,Engram 的架構設計允許將高達千億參數(100B+)的龐大嵌入表卸載 (Offload) 到主機記憶體 (Host Memory) 中。在目前的伺服器硬體架構下,當討論到這種大規模的主機記憶體容量池化與擴充時,CXL (Compute Express Link) 技術正是最核心且被廣泛探討的落地解決方案。[6][7]
瀾起科技的 MRDIMM 與 CXL MXC 產品矩陣與技術領先地位
作為記憶體介面晶片領域的全球領軍者,瀾起科技已在 MRDIMM 與 CXL MXC 關鍵節點完成了深度佈局。
MRDIMM產品世代與效能規格
瀾起科技可提供用於 MRDIMM 的 MRCD/MDB 記憶體介面晶片組:
第一代 (Gen 1):支援高達 8800 MT/s 的資料傳輸速率。
第二代 (Gen 2):瀾起已率先推出第二代 MRCD/MDB 晶片組,支援的最高速率躍升至 12800 MT/s,相較於第一代大幅提升了 45%,並即將進入規模化應用階段。
瀾起科技是全球唯二量產第一及第二代MRCD/MDB晶片組的供應商之一。
瀾起科技三代 CXL 記憶體控制器(MXC)對比表格
| 比較維度 | M88MX5891/5851 | M88MX6852 (最新一代) |
| 主機介面物理層 | PCIe 5.0 (32 GT/s) | PCIe 6.2 (64 GT/s) |
| CXL協議支持 | CXL 1.1 / 2.0 | CXL 2.0 / 3.2 (支持 DCD, MLD) |
| 最高記憶體速率 | 1 channel DDR4/5 | Dual channel DDR5 |
| 記憶體通道配置 | 雙子通道 (Sub-channel) | 兩個獨立 DDR5 通道 (2x 80-bit I/O) |
| 微處理器架構 | 單 RISC-V | 雙 RISC-V (APU + SPU) |
| 安全特性 | 安全啟動/設備認證/鏈路完整性和資料加密 | TEE安全協定/後量子密碼學 |
| 封裝 | 19x19mm E1.S, E3.S, AIC | 25x25mm E3.S, AIC |
關鍵技術規格與效能
超高頻寬與速率: 基於 PCIe 6.2 實體層介面,資料傳輸速率高達 64 GT/s (x8 通道)。支援多速率與多位元寬的彈性配置(例如可拆分為兩個 x4 通道)。
記憶體介面升級: 整合了雙通道 DDR5 記憶體控制器,運行速率最高可達 8000 MT/s,極大提升了主機 CPU 與後端記憶體模組之間的資料交換效率。
協定支援: 全面支援 CXL.mem 與 CXL.io 協定。
為了將架構理想轉化為商用現實,記憶體控制器的設計精度至關重要。瀾起科技針對不同應用場景,推出了橫跨三代、兼顧成本與極致效能的 MXC 產品矩陣:
資產活化與 TCO 優化 (M88MX5891/5851): 支援混合記憶體介面,不僅相容 DDR5,更支援 DDR4-3200 的重用 (Reuse)。這讓資料中心能在不報廢既有 DDR4 資產的前提下,快速建構 CXL 擴展架構,增加投資回報。
次世代更高頻寬 (M88MX6852): 領先業界導入 PCIe 6.2 (64 GT/s) 介面與雙通道 DDR5 控制器,將記憶體速率推升至 DDR5-8000,匹配 CXL 3.2 協定下的高效能 AI 運算需求。
系統效益分析:輸送量、成本與 ROI
整合 Engram 演算法、MRDIMM 頻寬提升與 CXL 彈性記憶體擴展後,系統展現了卓越的「規模經濟」效應。[4]
性能提升:在數據並行訪問模式下,CXL 記憶體池可為推論系統提供超過 45% 的輸送量增長。
TCO 成本模型 (400B Engram, 16 節點):
○ 傳統本地擴展: 每個節點需獨立配置高容量記憶體,總成本高達 $192,000 。[4]
○ CXL 池化方案與 CXL NUMA:每個節點透過配置中低容量記憶體並使用 CXL 進行擴展的模式,記憶體共用總池化成本為 $25,960,較傳統本地擴展低。
○ ROI 評估:相比之下至少可節省超過 $166,040 的基礎設施成本。這證明了「規模化下的指數價值 (Exponential Value at Scale)」:隨著節點數增加,CXL Memory 的邊際成本遞減,將基礎設施成本曲線從陡峭的線性增長轉變為平緩的經濟擴展。[4]
總結:定義下一代 AI 推論標配
面對 LLM 時代的「記憶體牆」,單點突破已無法滿足需求。「演算法稀疏化 + 記憶體分層化」的深度協同是必然的發展路徑。在這一架構中,MRDIMM 承載了高頻寬的動態查詢路徑,解決了實時性瓶頸;而 CXL MXC 則作為彈性記憶體容量,解決了擴展性與 TCO 問題。瀾起科技透過其業界領先的 MRCD/MDB 與 MXC 晶片解決方案,為這一未來架構提供了最底層的硬核支撐。對於 AI 基礎設施架構師而言,MRDIMM 與 CXL 的組合已不僅是技術選項,更是構建下一代高性能 AI 推論系統的「標準配置」。
參考文獻
[1]
DeepSeek-AI. (2024/2025). "DeepSeek-V3 / DeepSeek-R1 Technical Report."
Meta AI. (2024). "The Llama 3 Herd of Models." arXiv preprint arXiv:2407.21783.
Aminabadi, R. Y., et al. (Microsoft DeepSpeed). (2022). "DeepSpeed Inference: Enabling Efficient Inference of Transformer Models at Unprecedented Scale."
[2]
Kwon, W., et al. (vLLM Team). (2023). "Efficient Memory Management for Large Language Model Serving with PagedAttention." Proceedings of the 29th Symposium on Operating Systems Principles (SOSP).
Hooper, C., et al. (UC Berkeley). (2024). "KVQuant: Towards 10 Million Context Length LLM Inference with KV Cache Quantization." Conference on Neural Information Processing Systems (NeurIPS 2024).
[3]
Compute Express Link (CXL) Consortium. (2023/2024). "Compute Express Link (CXL) Specification 3.1 / 4.0 Architecture."
JEDEC Solid State Technology Association. "Multiplexed Rank Dual Inline Memory Module (MRDIMM) Core Specification."
[4]
DeepSeek-AI, "Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models," arXiv preprint arXiv:2601.07372, 2026. Available: https://arxiv.org/abs/2601.07372
[5]
Montage Technology, "Quantitative Performance Analysis of MRDIMM 8800 vs. DDR5 6400 in AI Inference Scenarios," Montage Technology AI Server Lab, Internal Test Report, Apr. 2026.
[6]
DeepSeek-AI, "Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models," GitHub repository, Jan. 2026. [Online].
[7]
Pooling Engram Conditional Memory in Large Language Models using CXL," arXiv preprint arXiv:2603.10087, Mar. 2026.
