 内存互连
 PCIe®互连
 CXL®互连




 联系我们

 2026-10-19
AI 推理的十字路口:当“参数规模”撞上“内存物理极限”
当前大型语言模型(LLM)正经历从十亿(Billions)到万亿(Trillions)参数规模的急剧演进。随着上下文长度(Context Length)迈向百万级,传统以增加 GPU 数量与 HBM(高带宽内存)为核心的扩展模式已达到物理与经济极限。一个关键的技术现实是:在 1M 上下文环境下,单个请求所需的 KV Cache 高达 150GB,这使得局部 HBM 不仅是“昂贵”,在面对高并发的生产环境时,其扩展性在物理层面上已变得难以维系。根据 2020 年 GPT-3 (175B) 到预测 2026 年的演进趋势,我们正处于一个关键节点:
参数与内存线性同步: 从 Llama 3 (8B/14GB) 到 Future LLM (1T/2000GB),内存需求随参数规模线性飙升。如Fig1 [1]
长上下文的 KV Cache 爆炸: 从 8K 长度的 1.3GB 到 1M 长度的 150GB,HBM 供需缺口正持续扩大。如Fig2 [2]
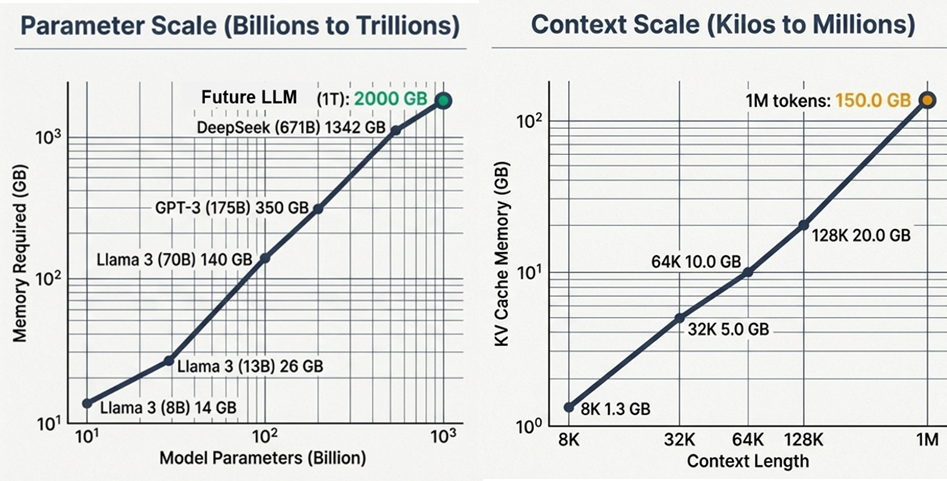
Fig1. Parameter Scale[1] Fig2. Context Scale[2]
算法演进:从混合专家模型 (MoE) 到 DeepSeek Engram
为了解决稠密模型(Dense)运算带来的巨大负荷,LLM 架构正由“全激活”转向“稀疏激活(Sparse Activation)”。这一趋势为硬件分层存储创造了卸载(Offloading)的机会。
技术深度解析:内存状态的解耦逻辑
Standard Transformer: 采用稠密运算,所有参数在每个 Token 生成时皆处于激活状态,内存完全锁定在昂贵的 GPU HBM 中。
MoE (Mixture of Experts): 通过路由选择仅激活 top-k 专家,虽然计算量降低,但仍对 GPU HBM 的利用率有极高要求。
DeepSeek Engram: 引入了条件记忆(Conditional Memory) ,为稀疏化开辟了全新维度。Engram 核心逻辑:计算与查询的数学解耦。Engram 将模型中的静态知识(Static Knowledge)提取为 O(1) 的 N-gram 查找表。这在架构上实现了数学解耦:动态推理(Dynamic Reasoning)[4]。
O(1) 查表与 Host RAM 卸载:DeepSeek与北京大学联合发表的论文“Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models” 中明确指出,通过将庞大的 N-gram 查找表(最高达 100B 参数等级)完全卸载至 CPU Host RAM,并利用 Deterministic Addressing(确定性寻址)进行预先读取(Prefetching),可以在不占用宝贵 GPU HBM 的情况下,实现极低延迟的O(1) 知识检索。论文实测显示,这种将内存卸载至 Host DRAM 的做法,对整体吞吐量的效能折损不到 3%。[4]
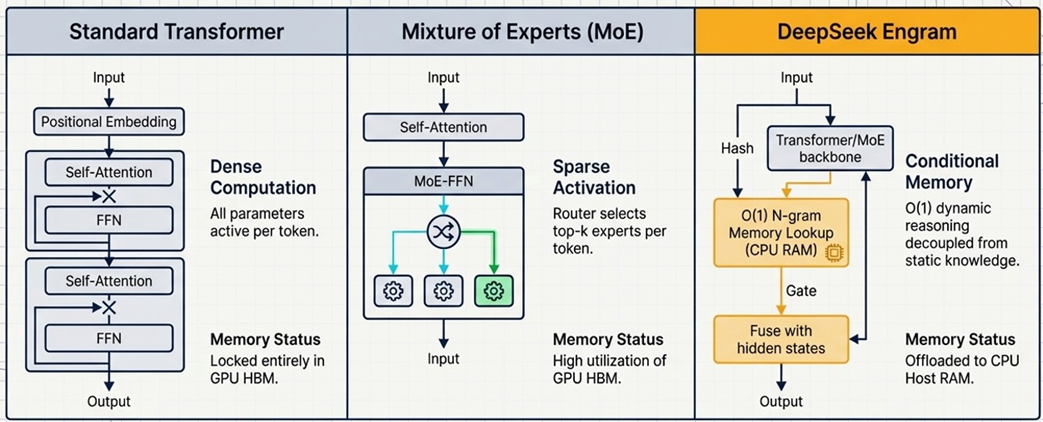
Fig3. 算法演进:从混合专家模型 (MoE) 到 DeepSeek Engram [4]
MRDIMM:主机内存带宽的二次飞跃
当 Engram 将知识查询表卸载至主机侧,传统 RDIMM 在面对频繁且高并发的动态查询时,其带宽与延迟表现往往力不从心。 MRDIMM(多路复用双列直插内存模块) 是应对这一高性能查询需求的核心组件。
硬件架构拆解:伪通道与多路复用
MRDIMM 通过多路复用架构配合改进的内存控制器实现了带宽的二次飞跃:
多路复用拓扑: 借由多路复用寄存时钟驱动器(MRCD)与多路复用数据缓冲器(MDB),系统能同时访问两个物理阵列(Rank)。
80-bit 子通道技术: MDB 将来自 DRAM 侧的两个 80-bit 伪通道(PS0 与 PS1)信号多路复用为单个双倍数据速率信号,实现 2x Data Rate 的数据传输。
并行指令流: MRCD 同时向 PS0 与 PS1 发送指令,确保了极致的访问并行度。
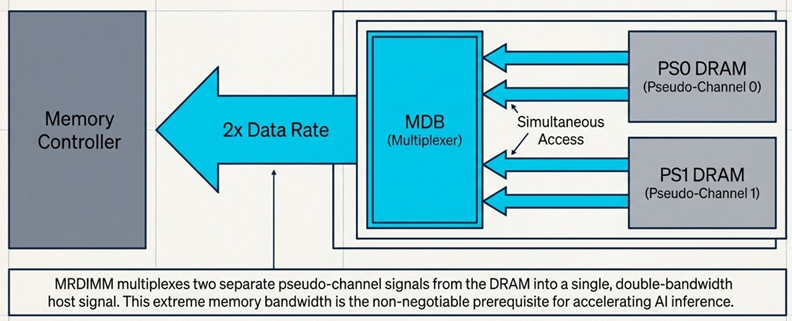
Fig4. MRDIMM 架构[3]
性能量化分析
MRDIMM 能够突破传统 DDR5 速率瓶颈的核心,在于其创新的多路复用缓冲架构。
芯片组配置:根据 JEDEC 规范,一根标准的 MRDIMM 需要搭载 1 颗 MRCD(Multiplexed Rank Clock Driver)和 10 颗 MDB(Multiplexed Data Buffer)。
数据多路复用(Multiplexing):MDB 芯片允许两个不同的 Rank 在同一个频率周期内进行并行存取。通过MDB芯片内部电路,将多个 DRAM 颗粒的低速数据流进行多路复用处理,MRDIMM能够向主机(Host)端输出两倍于后端原生 DRAM 的传输速率。
性能量化分析在 AI 推理场景的实测对比(MRDIMM 8800 vs. DDR5 6400)显示:[5]
吞吐量优势: 在并发数为 8 的高负载下,MRDIMM 达到了 39.20 tps ,较 DDR5 6400 的33.00 tps 提升约 18.8%。 若相较于基础的 DDR5 4800,提升幅度更高达 40.5%。
延迟控制: MRDIMM 在高并发下能将 Token 间延迟稳定维持在 250ms SLA 以下(实测约 206ms),相比之下,DDR5 6400 的延迟已逼近临界值(243ms),而 DDR5 4800 则已超标(268ms),显示 MRDIMM 能更稳妥地确保推理服务的流畅度。
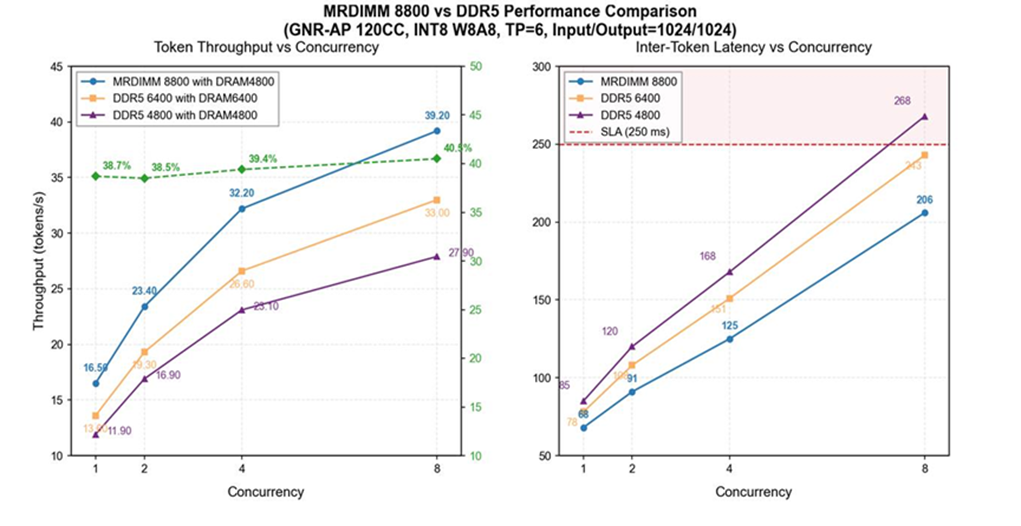
Fig5. Token Throughput and Latency Efficiency [5]
CXL® MXC:构建弹性扩展的内存资源池
带宽解决了“速度”问题,但面对万亿级参数带来的巨型 Engram 查找表,单机节点的插槽限制了“容量”上限。 CXL(Compute Express Link®) 协议下的 MXC(内存扩展控制器) 正是打破这一局限的、实现“内存扩展”的关键器件。
技术规格演进与基础
CXL 协议正依循 PCIe® 的发展路径实现跨越式进步:
CXL 1.0/1.1: 基于 PCIe 5.0,提供 32GT/s 的一致性内存访问。
CXL 3.0: 基于 PCIe 6.0,提供 64 GT/s 的传输速率,核心突破包括支持内存共享 (Memory Sharing)、多级交换架构 (Fabric),以及新增的多头设备 (Multi-Head) 功能,实现了无交换机直连与大规模资源解耦。
CXL 4.0: 预计基于 PCIe 7.0 ,带宽将飙升至 128GT/s 。
CXL NUMA: MXC 支持将 CPU 内存资源扩充,将每个 CPU core 所分配到的内存资源最大化。
消除 AI 幻觉的数学 prereq
扩大内存容量不仅是工程需求,更是数学上的必然要求。实测数据显示:
哈希冲突率: 随着内存容量扩张,Engram 查找表的哈希冲突率可从 3.01% 急剧降低至 0.13% 。
准确性提升: 降低冲突率是减少模型错误匹配、消除“AI 幻觉”的数学先决条件。
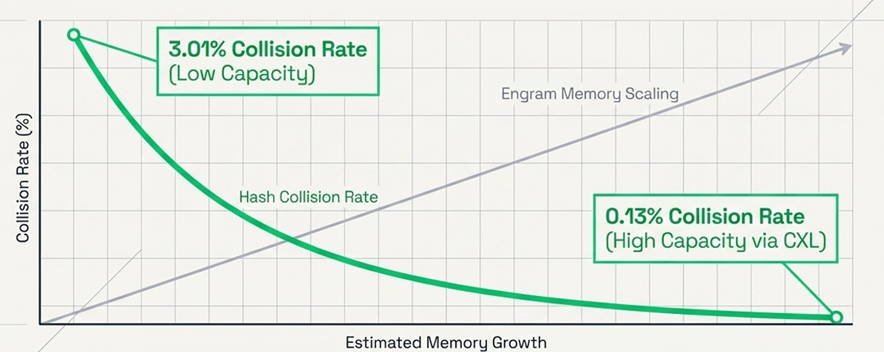
Fig6.Hash Collision vs. Memory Growth [6]
Engram 模块与哈希冲突 (Hash Collision)
DeepSeek 在论文中提出了“Engram”条件内存模块,其运作原理是利用 O(1) 的多头哈希寻址(Multi-Head Hashing)来查找模型所需的静态知识。只要使用哈希表,系统就必然会面临“哈希冲突”的数学物理限制。要降低冲突率、确保知识检索的准确性(进而消除 AI 幻觉),最直接的数学先决条件就是大幅扩大哈希表的内存容量 (Memory Scaling)。这正是图表中 X 轴(预估内存增长)与 Y 轴(冲突率下降)所呈现的完美反比关系。[6]
突破 GPU 限制与 CXL 扩展 (High Capacity via CXL)
为了解决 GPU 高带宽内存 (HBM) 容量严格受限的问题,Engram 的架构设计允许将高达千亿参数(100B+)的庞大嵌入表卸载 (Offload) 到主机内存 (Host Memory) 中。在目前的服务器硬件架构下,当讨论到这种大规模的主机内存容量池化与扩充时,CXL (Compute Express Link) 技术正是最核心且被广泛探讨的落地解决方案。[6][7]
澜起科技的MXC与MRDIMM技术领先地位与产品矩阵
作为内存接口芯片领域的全球领军者,澜起科技已在 MRDIMM 与 CXL MXC 关键节点完成了深度布局。
MRDIMM产品世代与效能规格
澜起科技可提供用于 MRDIMM 的 MRCD/MDB 内存接口芯片组:
第一代 (Gen 1):支持高达 8800 MT/s 的数据传输速率。
第二代 (Gen 2):支持速率跃升至 12800 MT/s,相较于第一代大幅提升了 45%,并即将进入规模化应用阶段。
澜起科技是全球唯二量产第一及第二代 MRCD/MDB 芯片组的供货商之一。
澜起科技三代 CXL 内存控制器(MXC)对比表格
| 比较维度 | M88MX5891/5851 | M88MX6852 (最新一代) |
| 主机接口物理层 | PCIe 5.0 (32 GT/s) | PCIe 6.2 (64 GT/s) |
| CXL 协议支持 | CXL 1.1 / 2.0 | CXL 2.0 / 3.2 (支持 DCD, MLD) |
| 最高内存速率 | 1 channel DDR4/5 | Dual channel DDR5 |
| 内存通道配置 | 双子通道 (Sub-channel) | 两个独立 DDR5 通道 (2x 80-bit I/O) |
| 微处理器架构 | 单 RISC-V | 双 RISC-V (APU + SPU) |
| 安全特性 | 安全启动/设备认证/链路完整性和数据加密 | TEE安全协议/后量子密码学 |
| 封装 | 19x19mm E1.S, E3.S, AIC | 25x25mm E3.S, AIC |
关键技术规格与效能
超高带宽与速率: 基于 PCIe 6.2 物理层接口,数据传输速率高达 64 GT/s (x8 通道)。支持多速率与多位宽的弹性配置(例如可拆分为两个 x4 通道)。
内存接口升级: 整合了双信道 DDR5 内存控制器,运行速率最高可达 8000 MT/s,极大提升了主机 CPU 与后端内存模块之间的数据交换效率。
协议支持: 全面支持 CXL.mem 与 CXL.io 协定。
为了将架构理想转化为商用现实,内存控制器的设计精度至关重要。澜起科技针对不同应用场景,推出了横跨三代、兼顾成本与效能的 MXC 产品矩阵:
资产活化与 TCO 优化 (M88MX5891/5851): 支持混合内存接口,不仅兼容 DDR5,提供主流内存性能,更支持 DDR4-3200 的重复利用 (Reuse)。这让数据中心能在不报废既有 DDR4 资产的前提下,快速构建CXL 扩展架构,增加投资回报。
下一代更高带宽 (M88MX6852): 领先业界导入 PCIe 6.2 (64 GT/s) 接口与双信道 DDR5控制器,将内存速率推升至 DDR5-8000,匹配 CXL 3.2 协议下的高效能AI运算需求。
系统效益分析:吞吐量、成本与 ROI
整合 Engram 算法、MRDIMM 带宽提升与 CXL 弹性内存扩展后,系统展现了卓越的“规模经济”效应。[4]
性能提升:在数据并行访问模式下,CXL 内存池可为推理系统提供超过 45% 的吞吐量增长。
TCO 成本模型 (400B Engram, 16 节点):
○ 传统本地扩展:每个节点需独立配置高容量内存,总成本高达 $192,000 。[4]
○ CXL 池化方案与CXL NUMA: 每个节点通过配置中低容量内存并使用CXL进行扩展的模式,内存共享总池化成本为 $25,960,较传统本地扩展低。
○ ROI 评估: 相比之下至少可节省超过 $166,040 的基础设施成本。这证明了“规模化下的指数价值 (Exponential Value at Scale)”:随着节点数增加,CXL Memory的边际成本递减,将基础设施成本曲线从陡峭的线性增长转变为平缓的经济扩展。[4]
总结:定义下一代 AI 推理标配
面对 LLM 时代的“内存墙”,单点突破已无法满足需求。“算法稀疏化 + 内存分层化”的深度协同是必然的发展路径。在这一架构中, MRDIMM 承载了高带宽的动态查询路径,解决了实时性瓶颈;而 CXL MXC 则作为弹性内存容量,解决了扩展性与 TCO 问题。澜起科技通过其业界领先的 MRCD/MDB 与 MXC 芯片解决方案,为这一未来架构提供了底层的硬核支撑。对于 AI 基础设施架构师而言,MRDIMM 与 CXL 的组合已不仅是技术选项,更是构建下一代高性能 AI推理系统的“标准配置”。
参考文献:
[1]
DeepSeek-AI. (2024/2025). "DeepSeek-V3 / DeepSeek-R1 Technical Report."
Meta AI. (2024). "The Llama 3 Herd of Models." arXiv preprint arXiv:2407.21783.
Aminabadi, R. Y., et al. (Microsoft DeepSpeed). (2022). "DeepSpeed Inference: Enabling Efficient Inference of Transformer Models at Unprecedented Scale."
[2]
Kwon, W., et al. (vLLM Team). (2023). "Efficient Memory Management for Large Language Model Serving with PagedAttention." Proceedings of the 29th Symposium on Operating Systems Principles (SOSP).
Hooper, C., et al. (UC Berkeley). (2024). "KVQuant: Towards 10 Million Context Length LLM Inference with KV Cache Quantization." Conference on Neural Information Processing Systems (NeurIPS 2024).
[3]
Compute Express Link (CXL) Consortium. (2023/2024). "Compute Express Link (CXL) Specification 3.1 / 4.0 Architecture."
JEDEC Solid State Technology Association. "Multiplexed Rank Dual Inline Memory Module (MRDIMM) Core Specification."
[4]
DeepSeek-AI, "Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models," arXiv preprint arXiv:2601.07372, 2026. Available: https://arxiv.org/abs/2601.07372
[5]
Montage Technology, "Quantitative Performance Analysis of MRDIMM 8800 vs. DDR5 6400 in AI Inference Scenarios," Montage Technology AI Server Lab, Internal Test Report, Apr. 2026.
[6]
DeepSeek-AI, "Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models," GitHub repository, Jan. 2026. [Online].
[7]
Pooling Engram Conditional Memory in Large Language Models using CXL," arXiv preprint arXiv:2603.10087, Mar. 2026.
